写给做 AI 多模态 / Agent / 毕设项目的同学:这是一篇工程复盘,讲我怎么从「一个分镜三张图、成本翻三倍」这条生成记录里,把图层拆分规则和导演风格这两件事重新设计了一遍。文末开放开源项目,我可以全程带大家找方向、捋思路、给落地方案。
前几天翻生成记录,看到一个数字有点刺眼。
一个分镜,本来一张配图就够了。
AI 给了三张。
一张是人物,一张是摊开的笔记本,一张是咖啡杯。三张图各调一次生图接口,还各做了一次抠图。成本翻了三倍。
更离谱的是另一个分镜。它干脆没生图,用二十三个形状图层,把一个人硬拼了出来。头发一个椭圆,左右眼各一个椭圆,嘴巴一个椭圆,再铺几根横条当代码行。
能跑。但不好看。
我盯着这两条记录想了挺久。这不是 AI 笨,是我没把规则写清楚。
一、先说我在做什么
我在做一个叫 canvas-director 的项目。
一句话:让 LLM 能编程的短视频创作。
现在的短视频工具大概分两类。一类是剪映这种,功能很强,但得你自己一帧一帧拖。另一类是一句话生成整片,很爽,但生成完是个黑箱,你想改一个字都不行。
我想做中间那一层。
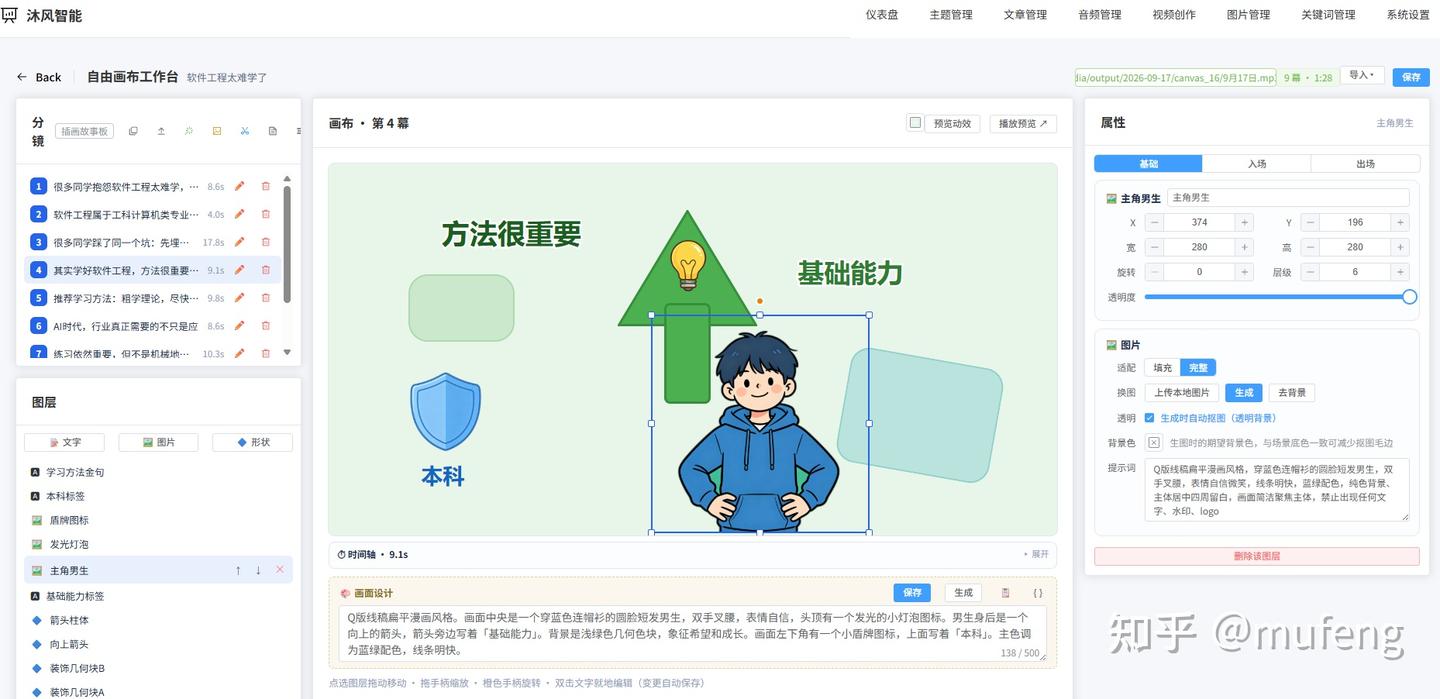
画面是一个网页,画布 854×480。每一幕是一组图层——文字、图片、形状,各自带坐标、字号、颜色、动效。
这些图层是一份 JSON,人能读、能改、能 diff,也能让 LLM 直接写。
写完交给浏览器渲染成视频。
整条管线长这样:
口播文案 + 配音 → LLM 切分镜(每幕一句旁白 + 画面描述)→ 导演稿(定全局配色、字体、风格、版式)→ 资产生成(贴图、图标)→ 装配(坐标、字号、动效)→ 浏览器渲染成视频
好处是:LLM 干它擅长的(规划、措辞、排列),浏览器干它擅长的(确定性渲染)。同一份 JSON 跑一百次,结果一模一样。
不是抽卡,是工程。
二、已经做完的部分
拿到口播文案和配音,先切分镜。然后是装配,装配被我拆成了三段:
| 阶段 | LLM 干什么 | 人干什么 |
|---|---|---|
| 导演稿 | 定全局:配色、字体、风格、每幕版式 | 定调性,看叙事顺不顺 |
| 资产 | 按清单生成贴图、图标 | 挑图、换图 |
| 装配 | 出坐标、字号、动效 | 最后审美把关 |
导演稿这一步我觉得挺关键。
以前是让 LLM 一步到位出图层 JSON,结果它一边想叙事一边想坐标,两头都顾不上。拆开之后,先立全局视觉系统,再逐幕落地,画面的一致性好了不少。
编辑器也做完了。左边分镜列表,中间画布,右边属性面板。图层能拖能缩放能旋转,文字能就地改,动效有独立的编辑入口。
跑通了,能出片。
但就是开头那个问题——成本控制不住。
三、问题出在哪
我把提示词翻出来看了一遍。
问题在装配那一段。原文里写着这么一句:
允许并鼓励使用 image 图层。
「鼓励」这两个字,是我写的。
当时的想法很朴素:多给点图,画面丰富一点。我没写一个字去限制图片数量。
LLM 很听话。它把一段画面描述,拆成了主体、道具、点缀,一个元素一张图。
我又去翻导演稿的提示词。那边写着「每幕 1\~3 个资产」。
又是一个没写上限的规则。
两个提示词叠在一起,结果是:十幕的片子,能生出二三十张图。每一张都是真金白银。
四、第一件事:拆图的判据是什么
我先想清楚一个问题——到底什么时候该拆?
一开始我以为答案是「画面丰富就拆」。后来发现不对。
真正决定能不能拆的,是动效。
一个图层,只能挂一套动效参数。它要么一起淡入,要么一起滑入。你想要标题先出、配图后滑进来、右上角的齿轮一直转着——这是三套动效,就必须是三个图层。
反过来,如果这几个元素是同进同出、待在那儿不动的,那它们合成一张图,画面反而更连贯。
所以规则其实就一句话:
这个元素,需不需要在时间轴上独立出场?
需要,才拆。不需要,就合成一张。
顺带我也把老问题一起解决了:文字,永远不交给图片。
让生图模型写中文字,出来通常是糊的。标题、要点、金句、数字,一律用文字图层——能描边、能渐变、能逐字出现,还清晰。
写进提示词的时候,我还加了一句成本说明。
因为 LLM 不知道一次生图多少钱。它得知道「每多一个图层就多一次调用」,才有动机去合并。
这条看着像废话。但只要不写,它就会很慷慨地给你拆。
这里要先打个预防针:这一切都还是 提示词层面的软约束。LLM 大体上会听,但不会每次都听。真要卡死成本,后面还得在校验环节加一道硬上限,比如超过两张就直接砍掉多余的图层。这一步我暂时没做,想先看看 PPT 风格实际跑出来什么样。
五、第二件事:给这套东西起名字
规则有了,接下来要落地成可选项。
我一开始想叫 style_preset,风格预设,听起来挺通用。
后来放弃了。因为在这个项目里,「风格」这个词已经被用了三次:
- 项目表上有个 style 字段,存画风关键词,比如「扁平插画、暖色调」
- 请求参数里有个 style_keywords,是这次生成要注入的画风词
- 还有个服务叫 style_prompt_service,把中文画风词翻成英文的生图正负向词
现在再加一个「选哪套提示词模板」的东西,如果也叫 style 系,三个月后我自己都分不清谁是谁。
所以最后定成了director_style,导演风格。
理由两个。一个是界面上按钮就叫「导演风格」,代码和界面用同一个词,不容易走偏。另一个是项目里已经有一堆 director 的东西了——导演稿、canvas_director.json、make_director。多一个 director_style,读起来是连贯的,不是凭空冒出来一个词。
顺便说清一件事:这个字段,和画风关键词是两回事。
画风关键词管「画面长什么样」,导演风格管「用哪套创作提示词」。
一个是内容参数,一个是模板选择。
我把它的值域做成了枚举。目前两个值:illustration(插画故事板)和 ppt(PPT 简报)。从取值上就和自由文本的画风词天然分开了,不会有人填错。
六、第三件事:风格存在哪
这条我觉得最值得说。
弹窗选完风格,这个选择要跟着项目一直走下去。因为后面还有一堆地方要用到它:单幕重新生成图层的时候、整片智能装配的时候、复制提示词拿去外部 AI 用的时候。
最容易踩的坑是:每次调用都传一遍参数。
传参的问题在于它会断。哪个接口忘了传,那一幕就用了默认风格,前后不一致。用户看到的是「怎么这一页跟别的不一样」,你却很难定位到底哪儿漏传了。
所以我没传参。
我把它写进了分镜文件里。选了「PPT 简报」,就落进 canvas_storyboard.json 的 director_style 字段。后面所有环节,谁需要就自己去读。
只有一个真源,没有第二个地方能改它。风格想漂也漂不了。
老项目的数据里没有这个字段。这种情况代码自动回落到默认的插画风格,不报错。
七、剩下的工程细节,一段话带过
剩下几块我就不展开了,列一下核心工程决策,感兴趣的同学可以对号入座:
- 交互时机:不在表单里塞选项,改成点【生成】时弹窗选择双风格卡片。生成后分镜面板标注当前风格,支持后期切换,同时弹窗风险提醒,保证画面叙事统一。
- 版式原型:复用原有八大版式,新增「要点条列页」「章节过渡页」两类 PPT 常用版式,统一存入全局版式字典,无需单独适配两套校验逻辑,兼容性更强。
- 落地形态:后端通过 DIRECTOR_STYLES 注册表统一管理风格配置,包含名称、说明、多阶段提示词、默认版式,前端接口拉取配置,异常场景内置兜底方案,模板缺失自动回落默认风格并告警,避免服务报错。
- 向后兼容:无 director_style 字段的老旧项目数据,自动适配默认风格,存量项目不受迭代影响,稳定性拉满。
八、为什么第一个新风格选 PPT 简报
做新风格的时候,可以选的方向挺多——手绘水彩、3D 卡通风、黑板粉笔、国风。我第一个选了 PPT 简报。
原因很实际。
这个工具主要用在教培和知识类内容上。这类内容的画面,很多时候就是「一页讲清一个点」,标题加几条要点,最多来个数字或流程。这些内容压根不需要一幅大插画。
而「以文字为主、配图为辅」恰好也是 成本最低 的形态。
PPT 风格的资产,优先让 LLM 直接写 SVG 图标——不用调生图接口,一分钱不花,风格还统一。整幕可以一张配图都没有,就靠文字、色块和几根分隔线排版。
同样是十幕的片子,插画风格可能要二十几张图,PPT 风格可能两三张就够,甚至零张。
而且它把我那条拆图规则用到了极致:不需要独立动效的元素,交给文字和色块。图片只在真的需要点缀的时候才出场。
内容对得上,成本又压得住。所以先做它。
九、验证到什么程度
没做完整的 A/B 对比。我做的验证是这些:
- 后端四个改动文件,语法检查全过
- 单独写了个小脚本,把注册表、风格名容错、三个阶段的模板解析、默认版式原型都跑了一遍
- 前端类型检查,我改的那个文件零报错
- 接口层面:风格清单接口返回正常;带新参数调生成接口能正确走到参数校验;老项目数据读出来不报错
- 成本侧:拿同一个文案跑两种风格的 token 预估,PPT 的模板更长,输入 token 确实上去了(导演稿 1919 变 1972,单幕装配 2375 变 2630)
最后那条其实是在确认一件事:模板真的按风格切了,而不是两个风格偷偷用了同一份提示词。
没验证的部分我也说清楚:生图成本的真实节省数字还没跑出来,现在只有 token 维度的对比;图层数量上限的硬校验也还没加。这两件事都在 backlog 上。
十、开源开放,我带大家深耕落地
写这篇的时候我有个感觉,这套东西的价值可能不在「生成」,在「规则」。
模型的能力其实是够用的。真正决定出片质量、决定成本高低的,是你有没有把约束讲清楚。
一个「鼓励」写下去,成本翻三倍。一条「是否需要独立动效」讲明白,成本和画面一起变好。
这类规则我还在一条一条补。
canvas-director 主打开放可编辑的视频管线与标准化格式。
我定义了 Canvas Video Format,将短视频标准化为可读、可改、可迭代的 JSON 图层结构,配套独立可部署的浏览器渲染器,所有人都可以直接克隆、运行、二次开发。项目采用 MIT 开源协议,完整格式文档、渲染器代码、示例案例全部公开。
针对想入局多模态、AI 视频方向的本科生、研究生,我可以全程 提供方向、梳理思路、输出落地方案,带你从零落地完整项目,适配毕设、科创项目、科研论文、工程实战等不同场景。
目前可深耕的核心方向非常清晰:
- 渲染器封装:打包独立可部署的前端播放器,完善工程化能力(当前最高优先级)
- 格式体系优化:迭代图层结构、动效模型、时间轴规则,完善标准化设计
-场景测试迭代:适配多类型文案、多风格画面,打磨管线稳定性
- 科研论文合作:基于整套工程体系,可落地论文研究方向,全程指导思路与方案
- 实战体验优化:上手试用项目,反馈使用问题,我针对性优化迭代
这次的拆图规则优化,就是从真实工程问题中迭代出来的。真正落地实操,才能发现行业通用的痛点与优化点。
如果你也在做 AI 视频、多模态生成相关项目,欢迎交流。我可以帮你定位项目痛点、优化技术方案、梳理迭代方向。
也想问问大家:你做 AI 视频开发时,遇到的成本失控问题是什么?是资产生成冗余、反复重试损耗,还是微小改动就要整片重跑?评论区聊聊。
附:文中数据来源
- 三张图的案例,出自本机项目 output/2026-09-21/canvas_25/ 的生成记录
- 成本与 token 对比数据,见 doc/hist/20260921-canvas视频导演风格与PPT简报提示词-工作总结.md